告别全局代理:为 DeepSeek Harness 实现多模型 API 域名精准分流
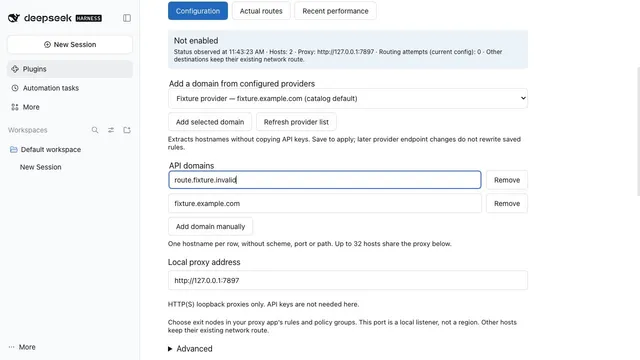
我在用 DeepSeek Harness 时,需要让特定模型 API 走本地代理,而其他直连端点保持原生链路。写了个小插件 dsh-domain-proxy,直接按域名做分流,不用改 Provider 配置或重新填 Key,顺便记录真实的 TTFT 首字延迟与生成速率。
工作中的经验,试过的工具,做过的项目,也有一些日常记录。
我在用 DeepSeek Harness 时,需要让特定模型 API 走本地代理,而其他直连端点保持原生链路。写了个小插件 dsh-domain-proxy,直接按域名做分流,不用改 Provider 配置或重新填 Key,顺便记录真实的 TTFT 首字延迟与生成速率。
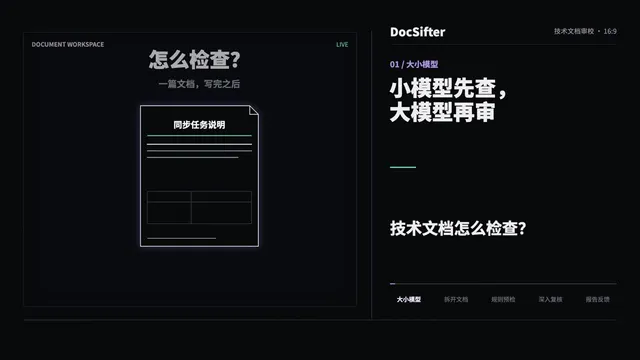
分享我们在中文技术文档场景下折腾的一个本地审校小工具 DocSifter。侧重代码结构保护、离线小模型基础纠错与误报沉淀,算是一点工程探索,现已开源供大家参考。
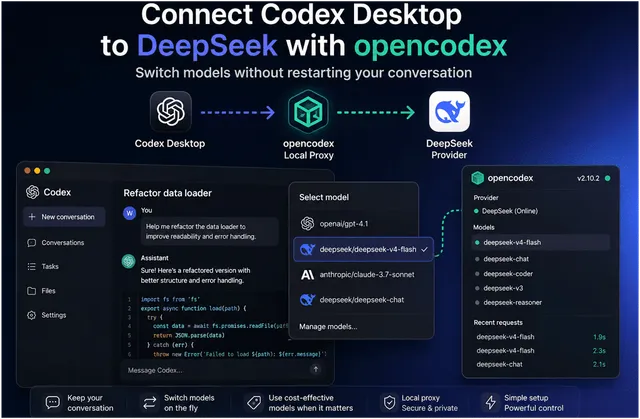
记录我如何用 opencodex 在 Codex Desktop 的同一个任务中切换 DeepSeek,包括安装配置、模型选择、启动日志排查和恢复原生 Codex。
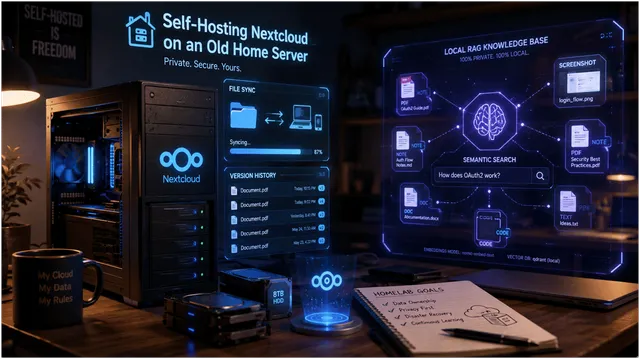
商业云盘放不了敏感内容、本地存储又有限,用旧主机跑 Nextcloud 是个出路:低成本扩容、VPN 远程连回家、文件改坏了拉时间轴找——后来顺手接进 RAG,工作文档变成可查询的 AI 知识库。
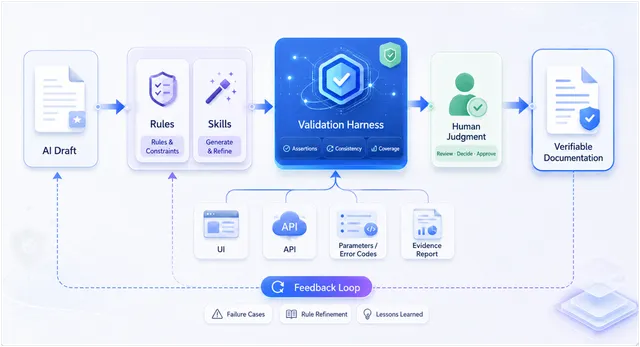
AI 能快速生成文档初稿,但如何保证其准确性与边界可控?本文分享了从单次 Prompt 试水、结构化受控生成,再到自动化 Harness 验证的文档工程化实践,探讨大模型时代下文档工程师的价值演进。
从框架选择、Docusaurus 配置、搜索、评论到 Netlify 部署,记录 Flowing Docs 个人博客搭建过程中的关键设置和实践经验。
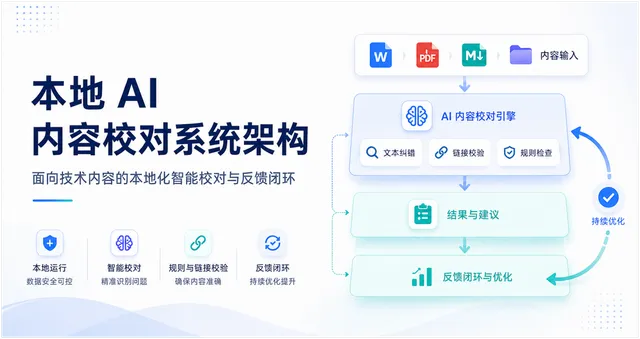
从技术文档审校中的错别字、术语误写和误报问题出发,分享一套本地中文 AI 文档纠错系统的设计思路,包括规则引擎、小模型、保护机制、Web 管理界面和持续反馈。
结合本地小模型 LLM 轻量校验、Codex Local 与 Codex Cloud,分享一套适用于 Doc-as-Code 技术文档的 AI 审校流程,以及 AGENTS.md 规则设计的落地经验。
通过苹果官网、高铁显示屏和商业招牌三个真实案例,深入分析信息设计中的常见问题,提供基于设计原则的改进方案,帮助提升用户体验和信息的清晰传达。
记录我为什么开始搭建 Flowing Docs / 知流小记,以及这个博客未来会关注的技术写作、开发者体验、AI 工具和生活实践方向。