在技术文档的写作与发布流程里,内容审校向来是一件性价比极低但又不得不做的事:人工逐字挑错费时费力,而直接拿通用 AI 或云端大模型去纠错,又极容易踩雷——模型分不清技术边界,随手就把代码注释改崩、把行内参数名翻译掉,或者把 API 网关 自作聪明改成 API 网管。更不用说在很多正式发版前,包含未公开架构的文档根本过不了公网 API 的数据安全合规。
过去这一年,为了在我们内部一个近 38 万字的技术文档库里安全落地自动化审校,我折腾了一套“本地优先、轻量小模型推理、带代码结构保护”的审校系统。
在上一篇文章分享完架构思路后,收到一些朋友关于源码的询问。其实它最初只是个内部“能跑就行”的粗糙脚本,算不上什么高大上的系统。为了能拿出来供有类似需求的朋友参考,这几个月花时间把代码重新脱敏整理,补齐了 Web 界面、Docker 和测试用例。
今天,把这套工具开源出来,希望能给大家提供一点参考。
DocSifter 正式开源,采用 MIT 协议。
想先看它怎么工作,可以直接打开交互式产品演示。
它是什么
简单说,DocSifter 是一个专为技术文档设计的“体检”工具:给它一个 Markdown、AsciiDoc 或纯文本文档目录,它结合规则引擎和本地中文小模型,挑出里面的错别字、术语误写和不通顺的表达,生成一份带修改建议对比和质量指标的 HTML 报告。支持 CLI、Web 界面和 GitHub PR webhook 三种接入方式。
读过前两篇文章的话,对它的思路应该已经有印象了。这篇主要补充背后的设计取舍,以及怎么在本地快速跑起来。
为什么不直接用现成工具
中文纠错工具不少,为什么还要自己做?
现有工具的问题不是能力不够,是场景对不上。通用纠错工具遇到技术文档容易过度纠错——API 网关 被改成 API 网管,代码注释被改坏。云端大模型帮得上忙,但技术文档里经常有未发布功能、内部架构和客户信息,送到外部服务这件事本身就需要额外审批。纯规则又覆盖不了上下文相关的表达问题。
核心矛盾在于:技术文档不是普通中文文章,一篇里可能同时混着 YAML 配置、Shell 命令、API 参数名和中英文混排的产品术语。纠错工具得知道哪些内容该看、哪些绝对不能动。这套系统的设计核心就是这个边界。
三层流水线
从轻到重,按需启用:
第一层:规则预览
  └─ 确定性问题(重复词、标点空格、固定术语拼写)
  └─ 无需下载模型,秒级响应

第二层:本地小模型纠错
  └─ shibing624/chinese-text-correction-1.5b(默认)或 7B
  └─ 完全离线,本地 GPU/CPU 运行

第三层:LLM 二次确认(可选)
  └─ 对小模型的发现再验证,过滤误报
  └─ 支持任何 OpenAI 兼容接口,也可以用自托管模型
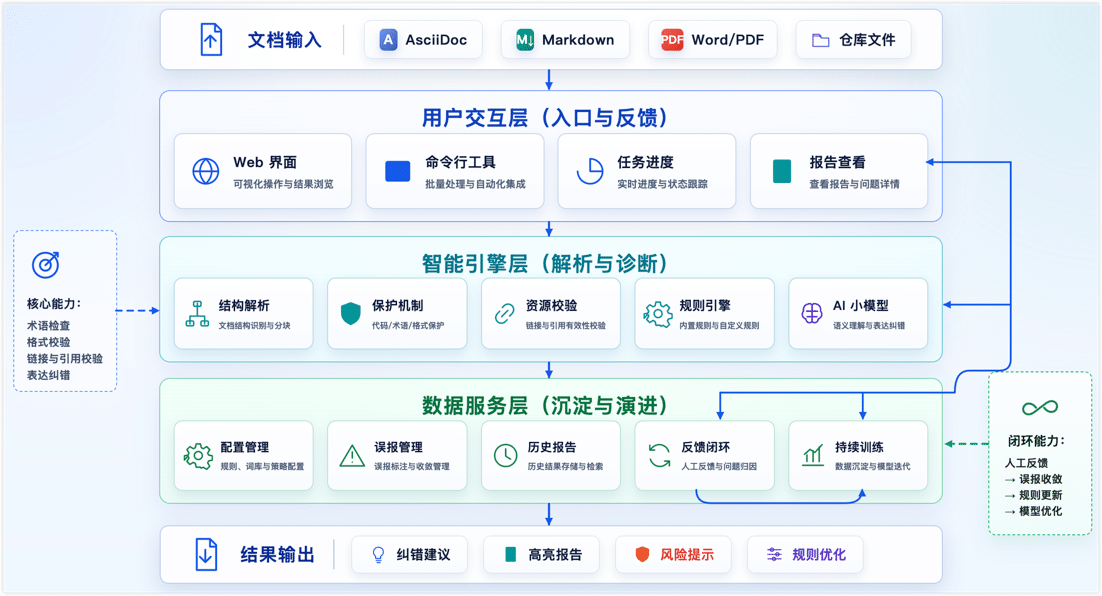
第一层没有任何模型依赖,装完就能跑。第二层是核心,处理规则覆盖不了的语义问题。第三层专门解决"小模型认为是问题,但其实不是"的情况——用一个更强的模型做二次判断,减少误报。三层都有独立的开关,可以单独用,也可以全部串起来。
几个设计取舍
数据不出本地
很多工具说"支持本地部署",实际上只是把 API 调用挪到了私有服务器。这里的本地优先是:默认不联网,第一次运行会自动下载模型权重(约 3.1 GB),之后完全在本地跑。
对文档团队来说,数据不出本地不是性能优化,是把这个工具接入内部流程的前提。如果需要用云端模型做第三层确认,可以显式配置,但这是主动选择,不是默认行为。
先保护,再纠错
任何内容送到模型之前,系统先做一轮结构解析:围栏代码块、行内代码、YAML/JSON 配置片段直接跳过;链接 URL、图片路径、API 参数名局部保护;不破坏 AsciiDoc 和 Markdown 的语法结构。模型只处理过滤后的纯文本段落,就算给出了有问题的建议,写回报告前还有一轮安全检查。
这是整套系统里最关键的工程设计,也是直接调用通用大模型审文档最容易出事的地方。
误报数据归团队所有
中文 AI 纠错用着用着,最先让人放弃的不是漏报,是误报。公司产品名、内部技术术语,工具一直报错,团队很快就不用了。
白名单、强制修复规则和误报过滤在这里都是本地持久化数据。用户通过 Web 界面点"拒绝"的建议,会自动沉淀为过滤规则,下次不再提示。这些数据不会随工具升级丢失——某种程度上,它们比工具本身更值钱,记录了团队在这个领域积累的判断。
后端可以换
本地 transformers 是默认,但后端可以替换成 Ollama 或任何 OpenAI 兼容接口:
export DOCSIFTER_MODEL_BACKEND=ollama
export DOCSIFTER_OLLAMA_BASE_URL=http://127.0.0.1:11434

# 或者 vLLM、DashScope、OpenRouter 等
export DOCSIFTER_MODEL_BACKEND=openai
export DOCSIFTER_OPENAI_BASE_URL="https://your-endpoint.example.com/v1"
切换后端不需要改代码,所有后端共用同一套保护管道。
跑起来
安装后先用规则预览模式验证一下(不下载模型):
pip install -e .
docsifter ./examples/sample-docs
启用本地小模型(首次会下载约 3.1 GB 权重):
pip install -r requirements-model.txt
docsifter ./examples/sample-docs --model shibing624/chinese-text-correction-1.5b
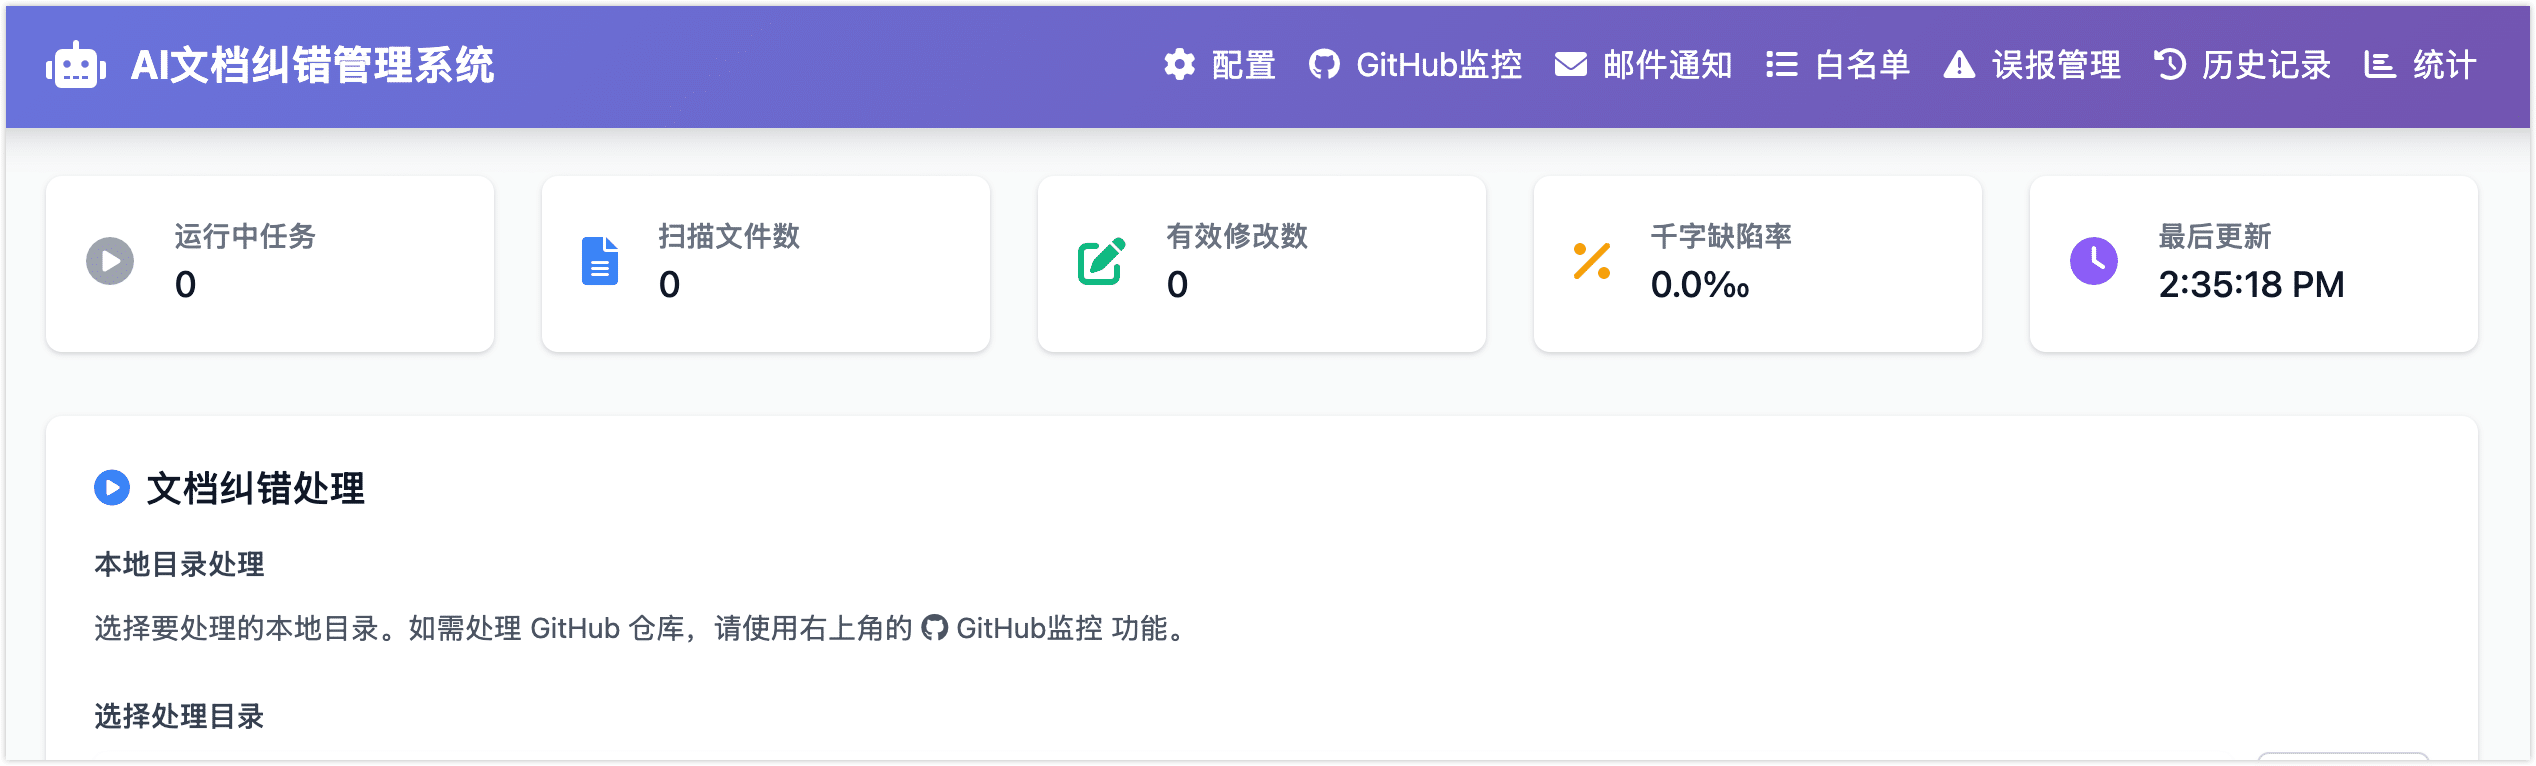
Web 界面:
docsifter-web
# http://localhost:8080
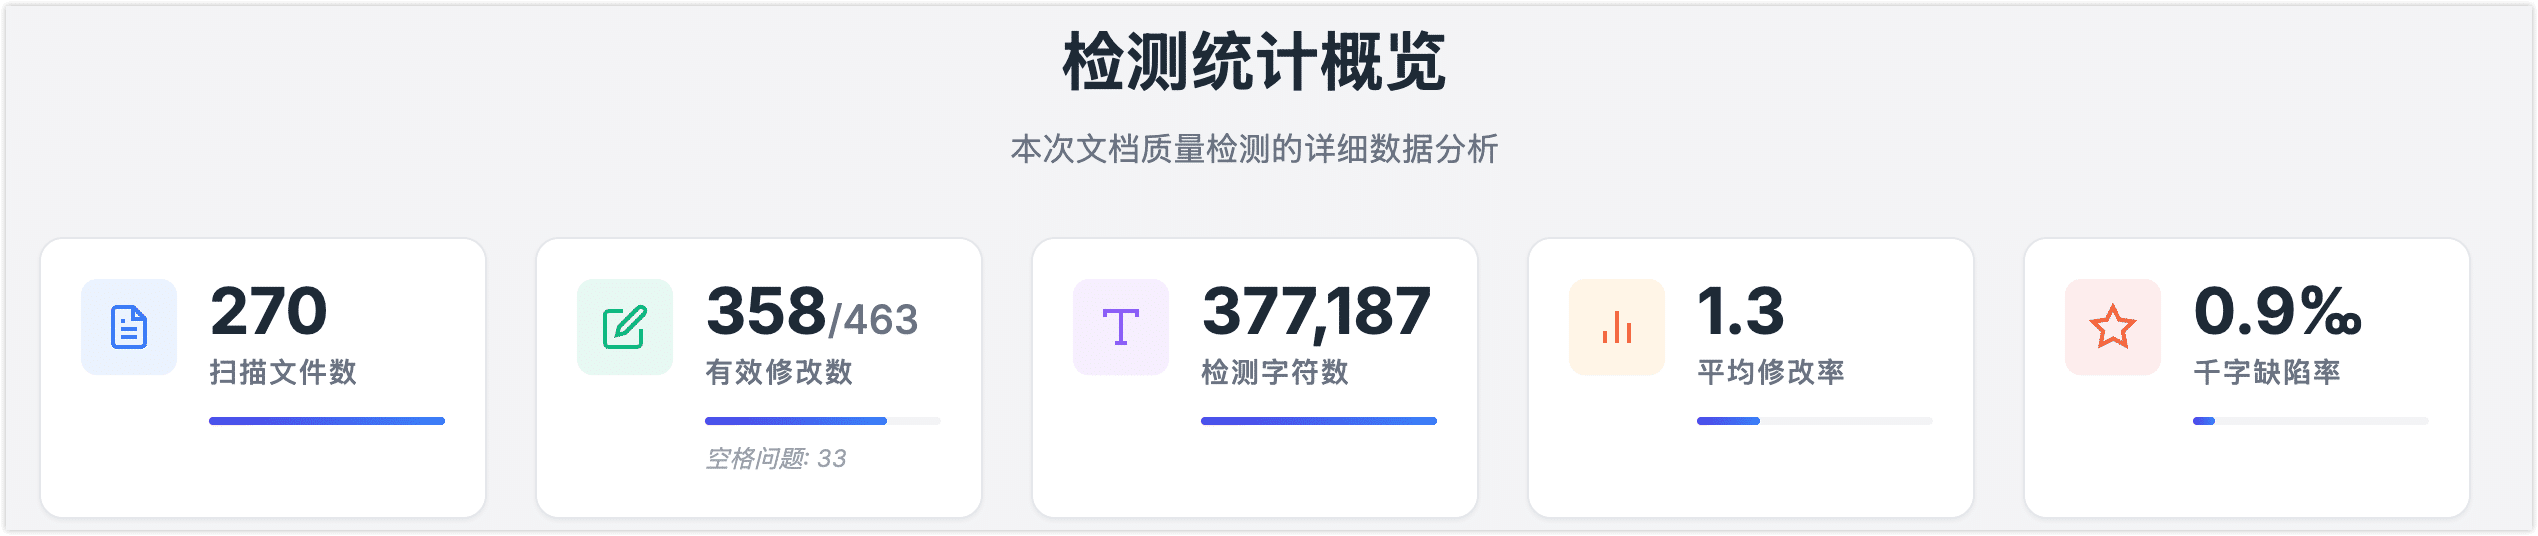
扫完生成自包含 HTML 报告,包含逐行修改建议对比、千字缺陷率等质量指标。前两篇文章里的截图就是这个输出——约 38 万字的技术文档仓库,RTX 3060 环境下扫描约 60 分钟,大概每秒 100 字。
能做什么,不能做什么
这套工具在基础文本质量上效率高,但有明确边界:它能发现错别字、术语误写、明显病句,发现不了"这段产品能力描述是否还准确"。后者需要配合 Codex 这类更强的 AI review 层(第一篇文章里有详细介绍)。它的定位也很聚焦,专门针对技术文档场景,不适合拿来审普通散文或小说。另外还有一点:目前只处理中文内容。
接入 Docs-as-Code 流程的话,有三个自然的位置:本地写作时用 CLI 做快速预检、提交 PR 前用 Web UI 批量扫描、PR 阶段通过 GitHub webhook 自动触发只检查变更文件。我们内部的用法是三者叠加,规则预览最轻、最快;小模型审校在提交前跑;Codex Cloud review 在 PR 阶段兜底。
为什么现在开源
做这个决定比整理代码花的时间长。
内部工具变成公开项目,不只是脱敏和写 README,还有一堆需要想清楚的问题:配置怎么设计才对陌生用户友好,安全边界在哪,单实例部署拓扑怎么说明,测试覆盖够不够。从原来 main.py 里的一堆函数,到现在有 CI、Docker 支持、结构化日志、Prometheus 指标端点的版本,中间是一段相当实在的重构。
原因倒也不复杂:这个系统在内部跑了将近一年,基本思路验证下来是可行的。搜索"技术文档 + 中文 + 本地 AI 审校",几乎找不到现成的工程化参考。如果有团队在处理类似问题,能少走一段弯路,就值得发出来。
GitHub:heywalter/docsifter
有问题或者用法上的需求,欢迎提 Issue。如果你们团队也在做文档质量工程,也欢迎在评论区聊——这类场景下每个团队的文档结构和术语体系差异很大,不同的踩坑经验通常都有参考价值。